La estafa que ya habla con la voz de su hijo
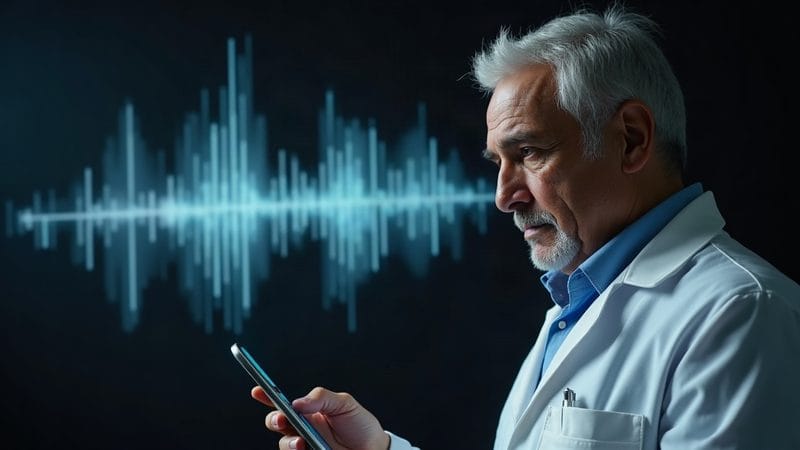
La clonación de voz por modelos generativos explota un reflejo neurobiológico que ninguna actualización de software puede parchar.
El teléfono suena a las tres de la tarde. Del otro lado no hay un contestador automático ni la voz metálica de un operador lejano. Quien habla, entre sollozos y respiraciones entrecortadas, es su hijo. Reconoce de inmediato el tono, la cadencia, el carraspeo característico y la forma en que pronuncia su nombre. Le dice que ha tenido un accidente grave, que está retenido y que necesita dinero urgente en una cuenta desconocida antes de que intervenga la policía. En ese instante exacto, su cerebro no evalúa probabilidades ni busca anomalías sintácticas: entra en pánico biológico. Sin embargo, su hijo está sentado en su salón de clases, ajeno a todo, mientras una computadora a cientos de kilómetros reconstruyó su identidad acústica utilizando un archivo de audio de tres segundos extraído de una red social.
Te voy a contar esto sin rodeos, como médico y como ingeniero: nos pasamos años debatiendo cuándo la inteligencia artificial alcanzaría la capacidad de engañar a un experto en una prueba de texto, mientras el verdadero peligro avanzaba por el flanco más desprotegido de la naturaleza humana. El canal auditivo no es un simple receptor de datos; es una línea directa con nuestro sistema de supervivencia más primitivo. Cuando la tecnología aprende a imitar la física del tracto vocal de un ser querido, la ciberseguridad deja de ser un problema de contraseñas y se convierte en una crisis de percepción neurológica.
La compresión acústica y el secuestro de la amígdala
Para entender por qué caemos en este fraude, debemos mirar primero cómo procesa el sonido el cerebro humano. Cuando escuchamos hablar a una persona conocida, la corteza auditiva primaria no trabaja de forma aislada. La señal acústica se proyecta casi de inmediato hacia el sistema límbico, en particular hacia la amígdala y el hipocampo, donde residen la memoria emocional y los circuitos de alerta temprana. La voz de un hijo, de una madre o de una pareja posee una firma biométrica única compuesta por formantes, frecuencias fundamentales y microvariaciones articulatorias que el cerebro almacena desde hace años.
En condiciones de estrés simulado —un llanto, un grito de fondo o una respiración agitada—, la amígdala activa una respuesta adrenérgica masiva: se acelera el pulso, se inhibe el juicio crítico de la corteza prefrontal y se prioriza la acción protectora inmediata. Los delincuentes no necesitan que la clonación de voz sea acústicamente perfecta en una escala de laboratorio; solo necesitan que sea lo bastante precisa para superar el umbral de reconocimiento emocional durante los primeros cinco segundos de la llamada.
Aquí interviene además un factor técnico que juega a favor del atacante: la red de telefonía convencional. Cuando hablamos por celular, el audio se comprime drásticamente mediante códecs diseñados para la voz humana que recortan frecuencias altas y bajas, transmitiendo apenas una fracción del espectro sonoro original. Este canal degradado actúa como un filtro natural que enmascara los pequeños artefactos sintéticos o la ligera rigidez metálica que todavía pueden producir los modelos de síntesis de voz. Si el modelo matemático produce un parecido del noventa por ciento, el canal telefónico y la adrenalina del receptor completan el diez por ciento restante.
Del estudio de doblaje al chip local sin control
Hace apenas unos años, clonar una voz humana con un realismo convincente requería horas de grabaciones en un entorno insonorizado, un procesador industrial y semanas de entrenamiento computacional. Hoy, los modelos neuronales de inferencia acústica, basados en arquitecturas de difusión y emparejamiento de patrones en tiempo real, solo necesitan lo que los ingenieros llamamos un esquema de aprendizaje con pocas muestras o few-shot learning.
Con una muestra de audio de tres a diez segundos —tomada de un video de cumpleaños subido a una plataforma pública, una nota de voz reenviada o una breve intervención en un seminario digital—, el algoritmo descompone la señal en vectores de características fonéticas independientes del texto. Es decir, separa el «cómo suena» del «qué dice». A partir de ahí, el sistema puede articular cualquier frase escrita en una pantalla conservando el timbre, el acento regional y las inflexiones emocionales del hablante original.
A mi juicio, el cambio más crítico en este escenario no es solo la fidelidad del sonido, sino la descentralización del cómputo. Durante años, la industria tecnológica sostuvo que los filtros de seguridad de las grandes plataformas en la nube impedirían que estos modelos se usaran para extorsiones. Bastaba con prohibir ciertas palabras clave o exigir verificación de identidad en los servidores corporativos. Esa defensa ha quedado obsoleta. Con la llegada de arquitecturas de hardware capaces de ejecutar inferencia neuronal compleja de forma local en computadoras personales y procesadores móviles de última generación, los modelos generativos abiertos se descargan y se ejecutan sin conexión a internet. El atacante no pasa por los filtros de ninguna empresa; opera en su propia máquina, sin bitácoras, sin límites de peticiones y con un costo marginal cercano a cero.
El espejismo de las marcas de agua y la defensa analógica
Frente a esta amenaza, los grandes laboratorios y los consorcios regulatorios insisten en la promesa de las marcas de agua digitales y los detectores automáticos de audio sintético. Se argumenta que, así como el papel moneda incluye hologramas y filigranas, cada archivo de audio generado por una máquina debería llevar una firma matemática incrustada en frecuencias inaudibles para el oído humano pero legibles para las redes de telecomunicaciones.
Este argumento suena impecable en los comités de estandarización, pero en la práctica técnica es frágil. Una marca de agua digital incrustada en un flujo de audio se destruye fácilmente mediante una simple recompresión, una conversión de formato analógico-digital o el simple ruido de fondo introducido deliberadamente en la llamada. Además, quien programa un modelo de código abierto con fines delictivos simplemente compila el código sin la subrutina que inserta la marca de agua. Exigir que los ciberdelincuentes respeten los protocolos de firma digital equivale a pedirle a un falsificador que utilice papel con sello oficial del banco central.
Por otro lado, delegar la defensa en sistemas de inteligencia artificial defensiva —filtros en las empresas telefónicas que analicen la llamada en tiempo real para advertir al usuario si la voz es artificial— plantea un dilema inaceptable de privacidad y latencia. Para que un software determine si la voz de su interlocutor es legítima, tendría que interceptar, decodificar y analizar el contenido semántico y acústico de cada conversación privada en tiempo real, creando una infraestructura de vigilancia permanente que ningún ciudadano libre debería aceptar con ligereza.
Si la solución no está en el software del operador ni en las promesas de autorregulación corporativa, ¿dónde queda el usuario? La respuesta exige un retroceso deliberado hacia lo físico y lo acordado previamente. La única defensa verdaderamente robusta frente a la clonación biométrica no es un algoritmo más complejo, sino un protocolo analógico: una palabra clave familiar pactada en persona, imposible de adivinar mediante ingeniería social y jamás mencionada en mensajes de texto o redes sociales; la regla inquebrantable de colgar de inmediato y marcar directamente al número habitual del familiar; y la desconfianza metódica ante cualquier urgencia que exija transferencias monetarias bajo presión emocional.
La tecnología ha logrado que los sentidos nos mientan con una precisión matemática sin precedentes. Nos enseñaron desde niños que ver para creer, y que escuchar a quien amamos era la prueba definitiva de su presencia. Hoy, esa certeza biológica ha dejado de ser un puerto seguro.
¿Estamos dispuestos a educar nuestro instinto para dudar de la propia voz de nuestros hijos antes de ceder al pánico?
Lo que la noticia no dice
La cobertura mediática sobre fraudes con clonación de voz suele centrarse en la sofisticación del software o en la audacia de los delincuentes, pero omite sistemáticamente la responsabilidad estructural del modelo de negocio de las telecomunicaciones y las plataformas digitales. Las operadoras telefónicas continúan permitiendo la manipulación del identificador de llamadas (caller ID spoofing) en la mayoría de las redes globales por razones de compatibilidad técnica y conveniencia comercial, facilitando que el atacante no solo clone la voz, sino que además haga aparecer el número real de la víctima en la pantalla del receptor.
Asimismo, mientras los consorcios promueven la venta de costosas herramientas corporativas de ciberseguridad, ninguna fuente responde a la pregunta de fondo: ¿por qué los gigantes tecnológicos no asumen responsabilidad civil cuando sus modelos de código abierto, publicados sin salvaguardas mínimas de autenticación, son utilizados como armas de extorsión masiva?
Conclusiones
- La clonación de voz de alta fidelidad ya no requiere muestras extensas ni supercomputadoras; modelos neuronales ligeros pueden recrear la firma acústica de una persona con fragmentos de audio de apenas segundos.
- La compresión de las redes telefónicas tradicionales degrada la señal de audio, actuando como un camuflaje técnico involuntario que oculta las imperfecciones del audio sintético.
- El éxito de estas extorsiones no radica en la perfección del algoritmo, sino en el secuestro emocional de la amígdala cerebral, que anula el juicio crítico ante la aparente angustia de un familiar.
- Las soluciones basadas en marcas de agua digitales o filtros en la nube resultan ineficaces frente a modelos generativos de ejecución local que operan fuera del control corporativo.
- La estafa que habla con la voz de su hijo solo se neutraliza mediante protocolos humanos y analógicos: la interrupción inmediata de la llamada, la verificación por canales alternos y el uso de palabras clave acordadas en privado.
Dr. Jose A. Cisneros, MD.Ph.D — drcisneros.com